الإرجاع البصري 10G/25G: تخطيط سرعة خط GTX/GTH وتفريغ UDP offload
حين تجتمع عدة ADC عالية السرعة أو حزم رادار أو تدفقات فيديو، يبلغ النحاس سقفه بعد أمتار قليلة، ولا يستطيع PCIe الخروج من الهيكل. الأسلوب الصحيح هو قيادة SFP+/QSFP مباشرة من مرسلات GTX/GTH داخل FPGA، وتفريغ مكدس MAC وIP/UDP على الرقاقة، وإرسال الحمولة فقط عبر الألياف بسرعة الخط. يحسب هذا المقال سرعة خط 10G/25G وحمولة UDP وميزانية الوحدة وتقسيم العمل داخل FPGA.
1. لماذا تحتاج البيانات عالية السرعة إلى الإرجاع البصري
داخل اللوحة يستخدم PCIe، والوصلات القصيرة بين اللوحات تستخدم النحاس؛ لكن حين تتوزع عقد الجمع، وتتجاوز المسافة بضعة أمتار، ويجرى كل قناة بعدة جيجابت/ث، يصطدم النحاس واللوحة الخلفية بالسقف أولاً:
1. سقف المسافة: كبل DAC عند 10G لا يدعم عادةً سوى 3–5 أمتار، والنحاس النشط محدود أيضاً؛ ويصل الألياف أحادي النمط مع الوحدة الضوئية بسهولة إلى 10 كم، ويناسب الصفائح الموزعة وواجهات الرادار البعيدة.
2. سقف العرض: قناة 1080p60 واحدة أو وسيط SDR متعدد القنوات أو IQ رادار مدمج تتجاوز غالباً 10 جيجابت/ث؛ ولا يحملها نحاس الجيجابت واللوحة الخلفية، فتحتاج SFP+ (10G) أو QSFP28 (25G/100G).
3. التوقيت والمناعة من التشويش: في البيئات الصناعية المزدحمة، يعطي الألياف عزلاً كهربائياً ومناعة من التداخل وحلقات التأريض، وتوقيتاً مشتركاً أكثر استقراراً بين العقد.
النمط المعتاد: بطاقة جمع بعيدة تقتصر على أخذ عينات ADC والمعالجة المسبقة، ثم تحزم النتائج وترسلها عبر ألياف واحدة إلى خادم مركزي لا يعالج القنوات فرادى، بل يستقبل التدفق المجمع فقط. هنا تحدد سرعة خط الوحدة ونفقات البروتوكول مباشرة عدد العقد الممكن ربطها.
2. سرعة خط 10G/25G وميزانية حمولة UDP (احسب الحمولة أولاً)
يعامل كثيرون «منفذ 10 جيجابت/ث» كعرض متاح، لكن طبقة التطبيق لا تستقبل إلا الحمولة بعد الترميز وفجوة الإطار ورؤوس البروتوكول. نبدأ من مصدر سرعة الخط:
| البند | 10G (SFP+) | 25G (QSFP28) | ملاحظة |
|---|---|---|---|
| معدل Ethernet الاسمي | 10.0 جيجابت/ث | 25.0 جيجابت/ث | المعدل الفعال لـ MAC |
| سرعة خط بعد ترميز 64b/66b | 10 × 66/64 = <span class=”hl”>10.3125 جيجابت/ث</span> | 25 × 66/64 = <span class=”hl”>25.78125 جيجابت/ث</span> | معدل البت الفعلي على الخط |
| نفقات إطار MTU 1500 | بادئة/SFD 8B + فجوة 12B + Eth 14B + IP 20B + UDP 8B | نفسها | ~62B غير حمولة لكل إطار |
| نسبة حمولة UDP | 1500/(1500+62) = <span class=”hl”>96.03%</span> | ≈96.03% | دون إعادة إرسال التطبيق |
| معدل حمولة UDP (MTU1500) | 10 × 96.03% ≈ <span class=”hl”>9.60 جيجابت/ث</span> | 25 × 96.03% ≈ <span class=”hl”>24.0 جيجابت/ث</span> | ما تستقبله التطبيق فعلاً |
| إطار جامبو (9000B) | 9000/9062 = 99.32% | 99.32% | يرفع الحمولة إلى ~9.93 / ~24.8 جيجابت/ث |
الاستنتاج الجوهري: عبر UDP وMTU1500 لا يسلم منفذ 10G للتطبيق إلا ~9.6 جيجابت/ث وليس 10. قدّر العقد على الحمولة: إن أرسلت كل عقدة 2 جيجابت/ث بيانات فعالة، فيستوعب خط 10G نحو 4–5 عقد (9.6 / 2 مع هامش) وليس خمسة كاملة. وللاقتراب من سرعة الخط فعّل Jumbo Frame لتوزيع النفقات الثابتة لكل إطار.
معدل الخطأ BER وميزانية الرابط
لا يكتمل الليف بمجرد توصيله؛ احسب أولاً ميزة القدرة الضوئية: قدرة الإرسال − حساسية الاستقبال = هامش الرابط، تخصم منه توهين الليف (أحادي النمط 1310 نانومتر ≈ 0.35 ديسيبل/كم) وفقد اللحام والموصل (~0.5 ديسيبل لكل موصل). وSR متعدد النمط 850 نانومتر محدود بالمسافة وOM3/OM4؛ ويصل LR أحادي النمط 1310 نانومتر إلى 10 كم. الامتثال يستهدف BER أفضل من 1e-12؛ ويضيف 25G عادةً RS-FEC فيصحح أخطاء خام ~1e-5 إلى 1e-15، فتضمين كسب ترميز FEC في الميزانية.
3. كيف يقسم FPGA العمل
1. مرسلات GTX/GTH تقود الوحدة الضوئية
يصل GTX سلسلة 7 إلى 10.3125 جيجابت/ث تماماً لمطابقة SFP+ 10G؛ وتعمل GTH/GTY في UltraScale/UltraScale+ فوق 16G وتدعم 25G. يتولى المرسل التسلسل/فك التسلسل وترميز 8b/10b أو 64b/66b واستعادة التوقيت؛ ويتبقى خارجياً الأزواج عالية السرعة وإدارة الوحدة عبر I2C (قراءة DDM).
2. MAC ومعالجة الإطارات
فوق المرسل يقع MAC Ethernet 10G/25G: تحديد الإطار وفحص CRC وتدفق PAUSE. يرمي الاستقبال الإطارات ذات خطأ CRC ويرشح بعنوان MAC الوجهة؛ ويغلف الإرسال الإطارات ويملأ الفجوات. هذه الطبقة خط أنابيب حتمي يصلح للأجهزة بالكامل.
3. محرك تفريغ UDP offload
جعل CPU يعبّئ IP/UDP لكل إطار يصبح اختناقاً عند 10G. التفريغ على الرقاقة: تعبّئ الأجهزة IP المصدر/الوجهة والمنافس والمجموع الاختباري؛ يكتب المستخدم الحمولة في مخزن DMA فقط، فيضيف المحرك رؤوس Eth/IP/UDP ويحسب المجموع الاختباري ويجزئ حسب MTU. لا يعبّئ CPU، بل يضبط جدول العناوين مرة عند التهيئة — هذا هو تفريغ المكدس.
4. إحصاء الأخطاء ومراقبة الرابط
تعدّ عدادات على الرقاقة أخطاء CRC والإطارات المفقودة وتصحيحات FEC وترفعها دورياً عبر قناة الإدارة؛ وتُجمع أيضاً قدرة الإرسال وقدرة الاستقبال الضوئية وحرارة الوحدة (DDM) للإنذار المبكر عند هبوط الهامش بدل انتظار صورة تالفة.
4. مثال هندسي: جمع متعدد العقد بالإرجاع عبر ألياف 10G
نظام جمع موزع ذو 4 عقد بعيدة؛ تدمج كل عقدة قناتي SDR وسيطاً وقناة فيديو، بإرجاع فعّال ~2.2 جيجابت/ث؛ يجمع المركز عبر ليف 10G واحد، ومع Jumbo Frame تبلغ الحمولة ~9.9 جيجابت/ث، فأربع عقد بمجموع 8.8 جيجابت/ث تترك هامشاً. كل البروتوكولات تفريغ UDP داخل FPGA، ويستقبل المضيف الحمولة فقط.
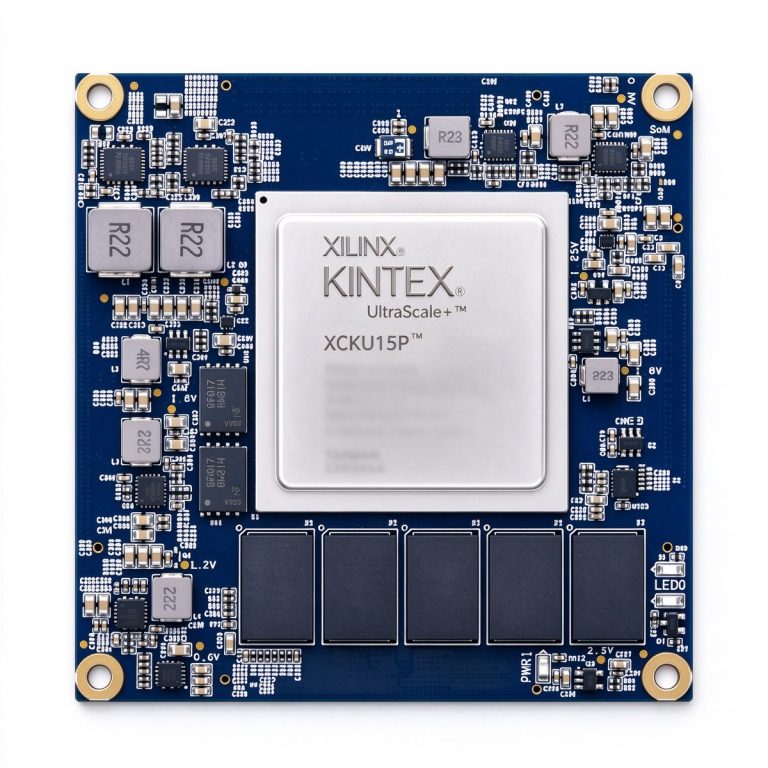
- عرض نطاق عالٍ (XCKU15P / Kintex UltraScale+): هامش مرسلات GTY كافٍ لـ25G أو عدة قنوات 10G، لعقدة التجمع الرئيسية التي قد ترتقي إلى 25G/100G.
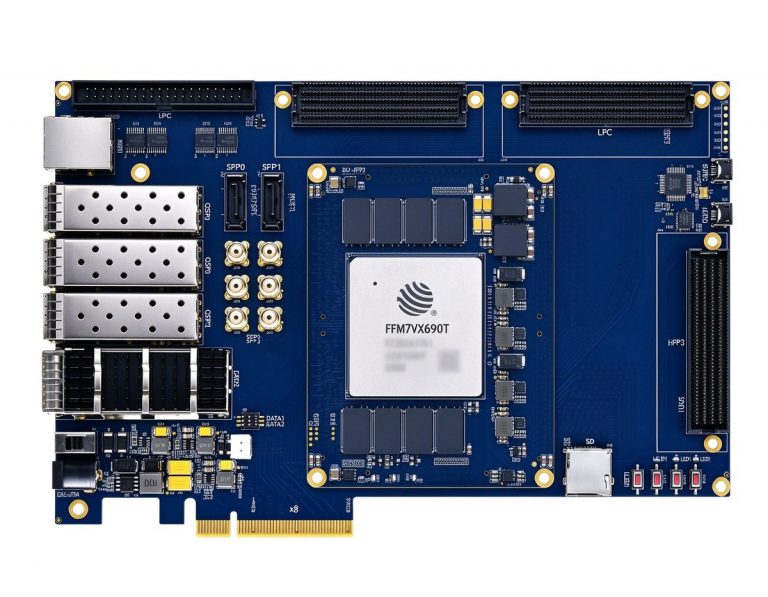
- تجمع عالي السعة (DUF7690T / JFM7VX690T): منطق وذاكرة على الرقاقة وافيان لعدة MAC ومحركات تفريغ UDP وطوابير كبيرة، لتجمع المركز متعدد العقد وإعادة التوجيه بسرعة الخط.
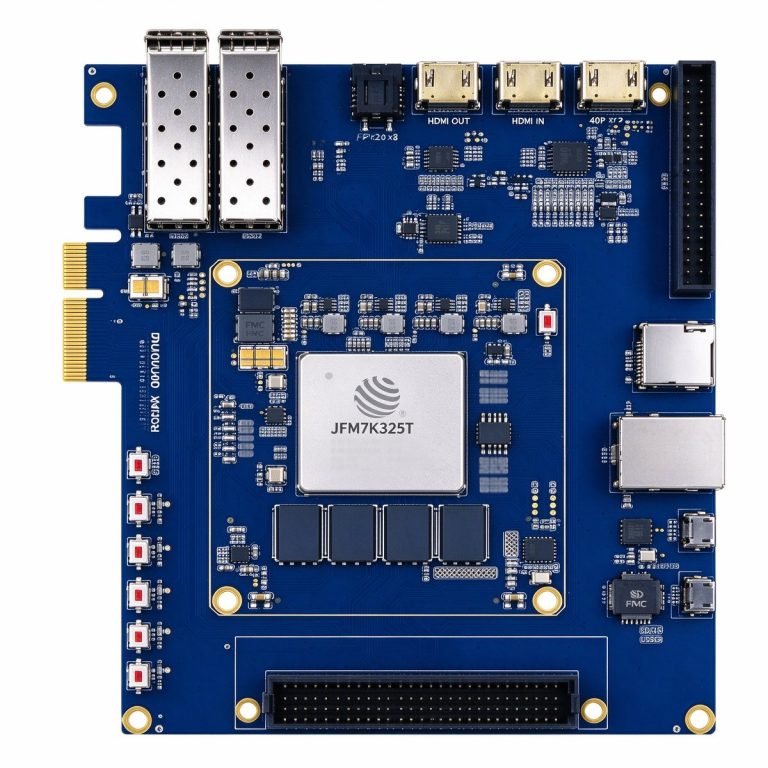
- مدخل نموذج 10G (DUK7325T / JFM7K325T): يملأ GTX سلسلة 7 سرعة خط 10G بتكلفة متوازنة، لنموذج عقدة واحدة 10G والمنتجات المدخلة.
جوهر الإرجاع البصري أن ينهي مرسلات FPGA ومكدسه العتادي مهمة «الإرسال بسرعة الخط» نيابة عن CPU. احفظ رقمين: عبر MTU1500 حمولة 10G ~9.6 جيجابت/ث و25G ~24 جيجابت/ث. قدّر العقد بالحمولة لا بالمعدل الاسمي، واحسب ميزانية الرابط وBER مبكراً، كي لا يهبط الإرجاع في الميدان.