أين تتوزع حمولة استدلال الذكاء الاصطناعي بين FPGA وGPU وASIC: التكلفة والطاقة والمرونة
يريد فريقك إضافة اكتشاف أجسام 1080p إلى بوابة، لكن المالية ترفض شراء GPU دائماً. ما مقدار النموذج المكمّم الذي يستطيع FPGA تشغيله فعلاً؟ ومتى يكون GPU ضرورياً؟ وعند أي حجم إنتاج يبدأ ASIC في تحقيق عائده؟ تضع هذه المقالة المسارات الثلاثة في دفتر تكاليف واحد.
1. «استخدم GPU» ليست الإجابة الوحيدة لنشر الاستدلال
عندما يفكر المهندسون في نشر استدلال الذكاء الاصطناعي، يكون GPU هو رد الفعل الأول: نظام CUDA بيئي كامل، مكتبات المُشغِّلات جاهزة، والنموذج يُحمَّل ويعمل. لكن اللحظة التي تصل فيها إلى منتج حقيقي، تنقلب المعادلة. يحتاج GPU إلى تبريد نشط، ويستهلك عشرات الواطات، ومكلف، ويشغل فتحة PCIe، ولا يتسع في الهيكل. في البوابات والكاميرات المدمجة وصناديق الحافة الصناعية حيث تكون الأبعاد والطاقة محدودة، يكون GPU غالباً «قابلاً للاستخدام لكن غير قابل للتركيب».
إذن السؤال الحقيقي: خارج نطاق GPUs، أين ترسم FPGA وASICs المخصصة (بما في ذلك مسرّعات NPU/TPU) حدودها؟ أي جزء من حمل العمل ينتمي إلى أي جهاز؟ هذه ليست مسألة مقارنة «من الأسرع»، بل مسألة اختيار تحددها ثلاثة متغيرات معاً: التكلفة لكل وحدة، والطاقة لكل وحدة، وتواتر تكرار النموذج.
2. الاختلاف الجوهري: نموذج التوازي وتدفق البيانات
الجذر الحقيقي للفجوة بين فئات الأجهزة الثلاث هو بنية الأجهزة، لا نتيجة معيار أداء.
| البُعد | GPU | FPGA | ASIC / NPU |
|---|---|---|---|
| وحدات الحساب | صفيف SIMT خيطي ضخم | صفيف LUT + DSP قابل لإعادة التشكيل | صفيف نابض ثابت / أنسجة موتر |
| تدفق البيانات | ذاكرة فيديو عامة → معالجة دفعية SM | BRAM / سجلات على الرقاقة بتدفق مباشر | تدفق SRAM ثابت على الرقاقة |
| الدقة | FP16/FP32 أصلية قوية | INT8 قابل للتخصيص، ضعف الفاصلة العائمة | INT8/INT4 محسّنة بدرجة عالية |
| الكمون | طوابير الدفعات، اهتزاز مستوى ms | خط أنابيب ثابت، حتمية مستوى µs | مستوى µs، بنية ثابتة |
| التهيئة | برنامج تشغيل + CUDA Runtime | دفق بت بعد التركيب والتوجيه | غير قابل للتغيير بعد التصنيع |
يشغّل GPU «أي نموذج ترميه عليه». يمرر FPGA البيانات مباشرة دون انتظار دفعة. يدير ASIC النموذج نفسه إلى الأبد بأعلى طاقة حوسبة لكل واط. عندما تستوعب هذا، ستصبح كل أرقام التكلفة أدناه منطقية.
3. دفتر التكاليف: NRE، تكلفة الاستدلال الواحد، دورة الحياة
قسّم التكاليف إلى ثلاثة أجزاء وسيختلف الاستنتاج عن الحدس.
| بند التكلفة | GPU | FPGA | ASIC |
|---|---|---|---|
| NRE لمرة واحدة | شراء لوحة، بضعة آلاف من اليوانات | أدوات EDA + جهد هندسي، أشهر-شخص | تصنيع الرقاقة + الأقنعة، ملايين اليوانات |
| تكلفة الاستدلال للأجهزة | عالية (فائض حوسبة عامة) | متوسطة (مقاس على القدر المطلوب) | منخفضة جداً (مُوزَّعة على الكمية) |
| تكلفة مراجعة النموذج | إعادة كتابة نواة CUDA، أسابيع | إعادة التركيب، أيام إلى أسابيع | مستحيل، إعادة تصنيع |
| حجم الإنتاج المناسب | أي حجم | آلاف إلى ملايين | مئات الآلاف+ |
المنحنى الأساسي هو استهلاك NRE: NRE في FPGA هي في الغالب وقت المهندسين ولا تُوزَّع على سعر الوحدة. NRE في ASIC هائلة، لكن تكلفة الوحدة تنهار بمجرد ارتفاع الكمية. قاعدة تجريبية: عند الكميات السنوية بين بضعة آلاف وعشرات الآلاف من الوحدات، يكون FPGA عادةً الأمثل تكلفة. فقط عندما تصل الكمية السنوية إلى مئات الآلاف ويبقى النموذج مستقراً لمدة 2–3 سنوات، يبدأ عائد NRE في ASIC.
4. الطاقة والتبريد: المقياس الأكثر حساسية للحافة
في أجهزة الحافة، تحدد الطاقة مباشرةً نظام التبريد وحجم الهيكل.
| المسار | استهلاك الطاقة النموذجي | التبريد |
|---|---|---|
| GPU فاخر (بطاقة استدلال) | 35–70 واط | مروحة نشطة |
| GPU متوسط/منخفض / iGPU | 10–25 واط | تدفق هواء سلبي |
| FPGA متوسط/كبير | 8–25 واط (يمكن تقليصه تحت 5 واط) | مشتت حراري سلبي |
| NPU مخصص / ASIC | 2–8 واط | مشتت حراري سلبي |
ميزة FPGA في استهلاك الطاقة ليست «طاقة قصوى أعلى»، بل أنه يمكنك حذف كل شريحة منطقية لا تحتاجها. احتفظ فقط بنوى الالتفاف، والواجهة الخلفية للتكميم، وقنوات DMA التي يحتاجها الكاشف. غالباً ما تبقى لوحة FPGA من فئة Kintex تشغّل اكتشاف INT8 بحوالي 10 واط على اللوحة كلها. هذا حاسم في صندوق حافة صناعي بلا مروحة.
5. المرونة وسرعة التكرار: ثمن تعديل النموذج
نادراً ما تُقفل مشاريع الذكاء الاصطناعي الصناعية من المحاولة الأولى. تُبدِّل فرق الخوارزميات الشبكات الأساسية واستراتيجيات التكميم ومعالجة ما بعد كل ربع سنة. هنا تتباعد المسارات الثلاث بشكل حاد:
- GPU: PyTorch → إعادة تصدير TensorRT؛ المُشغِّلات غير المدعومة تعني نوى مكتوبة يدوياً؛ التكيف الواحد يستغرق ساعات إلى أيام.
- FPGA: شبكة مكمَّمة تُجمَّد في خط أنابيب RTL؛ إعادة التركيب والتوجيه تستغرق ساعات؛ مُشغِّل جديد يعني RTL أو HLS، عدة أيام-شخص.
- ASIC: السيليكون مُختوم. تغيير النموذج يعني تصحيحات برمجية علوية؛ التغييرات الهيكلية الحقيقية تنتظر الشريحة التالية.
الاستنتاج مباشر: لا تلمس ASIC بينما النموذج لا يزال يتكرر بسرعة. يشغل FPGA الموقع الوحيد حيث تحتاج إلى حتمية على مستوى الأجهزة، لكنك تعلم أن النموذج سيتغير خلال ستة أشهر.
6. مصفوفة القرار: أي سيناريو يحتاج أي مسار
ندمج الخطوط الثلاثة في مصفوفة للمقارنة المباشرة:
| السيناريو | المسار الموصى به | السبب |
|---|---|---|
| استدلال دفعي سحابي، تحديثات نموذج متكررة | GPU | البيئة والحجم أولاً |
| صندوق حافة، تحت 10 واط، كمون حتمي | FPGA | أفضل طاقة وحتمية |
| مدمج في كاميرا، 100k+ سنوياً، نموذج مُجمَّد | SoC ASIC/NPU | أقل تكلفة لكل وحدة |
| نموذج أولي مخبري، تشغيل العرض بسرعة | GPU | أسرع تطوير |
| بروتوكولات متعددة + AI على شريحة واحدة | FPGA | منطق قابل للبرمجة، بلا شريحة جسر ثانية |
خطأ شائع: رؤية «AI» ثم الافتراض الافتراضي لـ GPU. في السيناريوهات التي يتعايش فيها «المعالجة المسبقة للـ AI + منطق الأعمال الفوري» — مثلاً تحسين الصورة والاكتشاف وجمع GbE وGPIO معاً في آن واحد — يكون FPGA هو الطريقة الأكثر اقتصاداً لجمع الثلاثة على رقاقة واحدة. يتولى GPU جزء AI فقط ويجبرك على إضافة متحكم مضيف منفصل لجسر البروتوكولات.
7. أين تناسب لوحات Duyuan الثلاث هذه المراتب
نُسقط المصفوفة على لوحات Duyuan المتاحة للشحن:
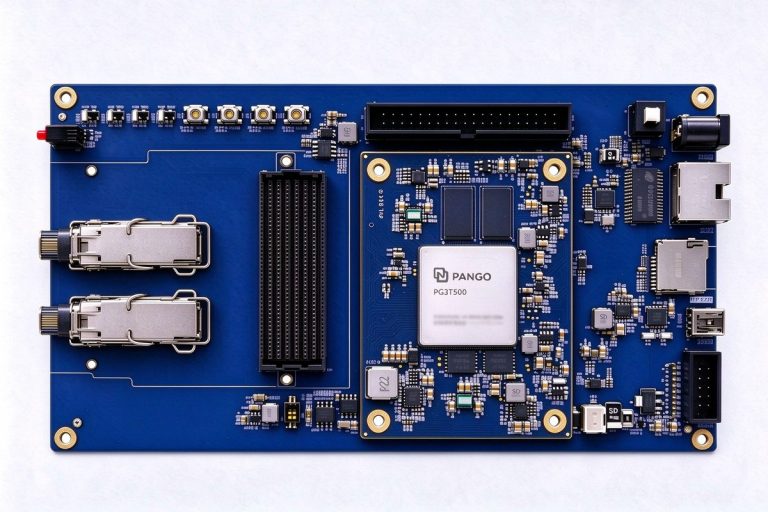
- DUPG3T500 (Pango Titan3، ~¥5,999): منصة تطوير FPGA وطنية فاخرة، مناسبة لفرق الخوارزميات في بناء النماذج الأولية لأجهزة INT8 المكمَّمة وتنفيذ منتجات البوابات صغيرة الدفعات مباشرة.
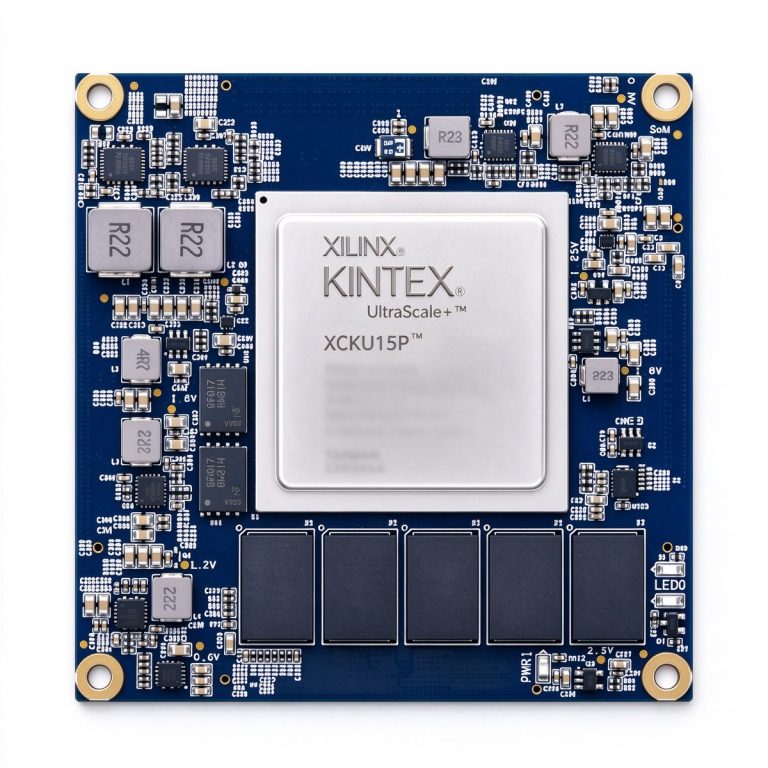
- DUKU15P (Xilinx Kintex UltraScale+ XCKU15P SOM، ~¥17,999): نسيج منطقي كبير + أجهزة إرسال عالية السرعة، للمنتجات متوسطة-الفاخرة التي تشغّل استدلال AI إلى جانب قنوات بيانات 10G متعددة.
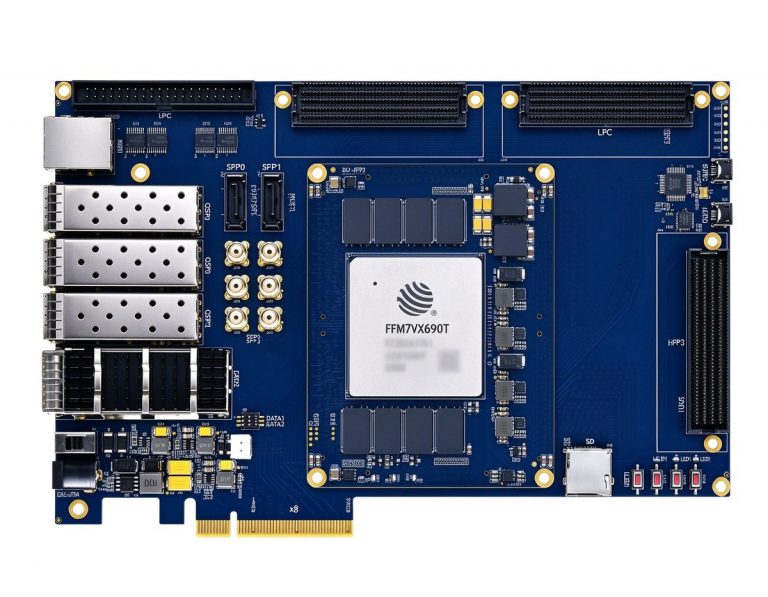
- DUF7690T (FudanMicro JFM7VX690T، متوافق مع XC7VX690T، ~¥24,999): منصة Virtex-7 وطنية صناعية للاستدلال المُجمَّد وإمداد دورة حياة طويلة في التطبيقات عالية الموثوقية.
| اللوحة | مستوى التموضع | حمل AI النموذجي |
|---|---|---|
| DUPG3T500 | نموذج أولي / بوابة صغيرة الدفعة | اكتشاف INT8، تصنيف |
| DUKU15P | متوسط-فاخر + I/O عالي السرعة | اكتشاف متعدد القنوات + اتصال صاعد 10G |
| DUF7690T | دورة حياة صناعية طويلة | نموذج مُجمَّد + إمداد عالي الموثوقية |
8. قائمة التنفيذ
ادفع مشروع حافة AI بهذا الترتيب لتجنب معظم إعادة العمل:
- حدّد ميزانية الكمون والطاقة أولاً، ثم احسب الطاقة الحسابية بالعكس: أجهزة الحافة بلا مروحة تُقيَّد عند 5–15 واط إجمالي، وهذا يُخرج GPU فوراً.
- اضبط النموذج على GPU أولاً، وقم بتكميمه إلى INT8، ثم فكّر في التجميد على FPGA — لا تضبط الخوارزميات على FPGA.
- حجم سنوي تحت 100k، سيتغير النموذج خلال سنة: اختر FPGA؛ لا تناقش ASIC في هذه المرحلة.
- حجم سنوي مئات الآلاف، النموذج مستقر عبر جيلين: ابدأ عندها تحليل NPU/ASIC لـ NRE.
- عندما يتعايش الجمع والبروتوكول وAI في منتج واحد، قيّم أولاً التكامل على شريحة FPGA واحدة بدلاً من GPU + متحكم مضيف.
اختيار جهاز استدلال AI ليس مسألة «من لديه أكبر FLOPs». بل هو مسألة من يربح معادلة تكلفة الوحدة داخل ضغط ميزانية الطاقة وساعة تكرار النموذج. FPGA ليس بديلاً عن GPU — بل يشغل موقع الحافة حيث تنجح المعادلة فعلاً.
قراءة إضافية
- كيف تختار FPGA: مصفوفة الموارد × الإرسال والسعة × السعر
- استدلال الذكاء الاصطناعي على لوحة الكاميرات المتعددة: دفتر نشر الحافة
- MPSoC مقابل FPGA الخالص مقابل MCU+ARM: ثلاثة مسارات غير متجانسة